OpenTextが選ばれる理由
OpenTextが選ばれる理由
概要OpenTextが選ばれる理由
OpenTextは数十年の専門知識を提供し、データのロックを解除し、人々とプロセスをつなぎ、信頼性を持ってAIを推進
データを管理し、接続する
企業全体でデータをシームレスに統合し、サイロを排除し、コラボレーションを改善し、リスクを軽減
AI対応情報
AIに対応し、データを構造化され、アクセスしやすく、最適化された情報に変換
組み込みのセキュリティとコンプライアンス
規制およびコンプライアンス要件を満たし、情報のライフサイクル全体を保護
どこでも展開可能
概要導入オプション
あらゆる規模のグローバル組織に対応するスケーラブルで柔軟な導入オプションを探る
主権クラウド
ローカルなコントロール、グローバルなスケールで信頼できるAIを活用。
プライベートクラウド
コントロールとコンプライアンスを維持しながら、クラウドの価値を引き出します。
オンプレミス
自社インフラストラクチャでデータを完全に管理
パブリッククラウド
選択したクラウドでビジネス情報を保護、拡張、利用
AIリーダーシップ
概要Aviator AI
新しい方法で情報を捉える
OpenText™ Aviator™
ビジネス、データ、目標を理解するAI
OpenText™ Content Aviator™
AIコンテンツ管理とインテリジェントなAIコンテンツアシスタントで業務を強化
OpenText™ DevOps Aviator™
アプリの配信、開発、自動化されたソフトウェアテストの加速を実現
OpenText™ Experience Aviator™
カスタマーサクセスのためのカスタマーコミュニケーションとカスタマーエクスペリエンスの向上
OpenText™ Service Management Aviator™
ユーザー、サービスエージェント、ITスタッフが必要な答えを見つけられるように支援
OpenText™ Trading Grid™ Aviator™
サプライチェーン全体でAIを活用したナレッジ、インサイト、およびガイド付きアクションを引き出す
Aviator AI
概要Aviator AI
新しい方法で情報を捉える
OpenText™ Aviator™
ビジネス、データ、目標を理解するAI
OpenText™ Content Aviator™
AIコンテンツ管理とインテリジェントなAIコンテンツアシスタントで業務を強化
OpenText™ DevOps Aviator™
アプリの配信、開発、自動化されたソフトウェアテストの加速を実現
OpenText™ Experience Aviator™
カスタマーサクセスのためのカスタマーコミュニケーションとカスタマーエクスペリエンスの向上
OpenText™ Service Management Aviator™
ユーザー、サービスエージェント、ITスタッフが必要な答えを見つけられるように支援
OpenText™ Trading Grid™ Aviator™
サプライチェーン全体でAIを活用したナレッジ、インサイト、およびガイド付きアクションを引き出す
Business Network
概要Business Network
一度接続するだけで、安全なB2B統合プラットフォームからすべてに連携
Content
概要Content
AI対応のコンテンツ管理ソリューションで知識を再構築
サイバーセキュリティ
概要Cybersecurity
企業保護のための統合サイバーセキュリティソリューション
DevOps
概要DevOps
AIを活用したDevOpsの自動化、テスト、品質向上により、より優れたソフトウェアをより迅速に提供
Experience and Fax
概要Experience and Fax
忘れられないカスタマーエクスペリエンスで会話を再考
オブザーバビリティとサービス管理
概要Observability and Service Management
IT運用のコストと複雑さを削減するために必要な明確性を獲得
API
概要APIs
Extend the value of your OpenText solutions by building integrations, automation and custom experiences
OpenText™ API Services
カスタムアプリケーションとワークフローを可能にするリアルタイムな情報フローを作成するOpenText Cloud APIを使用して、お客様独自の方法で構築
信頼できるデータとAI
概要信頼できるデータとAI
安全な情報管理と信頼できるAIの融合
OpenText™ Aviator™ Studio
データ言語でエージェントを構築、デプロイ、反復できる場所
OpenText™ Discovery
AIを促進するためのデータ取り込みとメタデータタグ付けを自動化するツールセット
OpenText™ Data Compliance
ガバナンスを積極的かつ持続的にするためのサービスとAPIのスイート
OpenText™ Aviator™ AI Services
AIのジャーニーをサポートするプロフェッショナルサービスのエキスパート
情報の再構築
概要情報の再構築
AIを活用した情報管理により、可視性が向上し、より鮮明な洞察が得られます。その方法を確認する準備はよろしいですか?
ナレッジの再構築
AIを活用したエンタープライズコンテンツ管理で日常業務を変革する
サービス管理の再構築
ITサービス管理、AIOps、可観測性のコストと複雑さを削減
つながりの再構築
サプライチェーン成功のためのAIを活用したB2B統合
会話の再構築
コネクテッドカスタマーエクスペリエンスで価値、成長、ロイヤルティを向上
エンジニアリングの再構築
アジャイル開発とソフトウェアデリバリー?決して不可能ではありません。
セキュリティの再構築
エンタープライズ向けサイバーセキュリティ
意思決定の再構築
AIデータ分析で洞察を引き出す
人工知能
概要Aviator AI
新しい方法で情報を捉える
OpenText™ Aviator™
ビジネス、データ、目標を理解するAI
OpenText™ Content Aviator™
AIコンテンツ管理とインテリジェントなAIコンテンツアシスタントで業務を強化
OpenText™ DevOps Aviator™
アプリの配信、開発、自動化されたソフトウェアテストの加速を実現
OpenText™ Experience Aviator™
カスタマーサクセスのためのカスタマーコミュニケーションとカスタマーエクスペリエンスの向上
OpenText™ Service Management Aviator™
ユーザー、サービスエージェント、ITスタッフが必要な答えを見つけられるように支援
OpenText™ Trading Grid™ Aviator™
サプライチェーン全体でAIを活用したナレッジ、インサイト、およびガイド付きアクションを引き出す
サービス内容
概要サービス内容
認定エキスパートによるガイダンスでデジタルトランスフォーメーションを加速
プロフェッショナルサービス
認定専門家と連携して情報管理を近代化
カスタマーサクセスサービス
専門家のガイダンス、マネージド サービスなどを活用してビジネス目標を達成
サポートサービス
サポートを戦略的優位性に変える
Managed Services
専門的なITサービス管理で社内チームの負担を軽減
ラーニングサービス
あらゆるスキルレベルのユーザーがOpenText製品を導入し、効果的に使用できるようにするためのトレーニングオプションをご紹介します。
ラーニングサービス
概要ラーニングサービス
あらゆるスキルレベルのユーザーがOpenText製品を導入し、効果的に使用できるようにするためのトレーニングオプションをご紹介します。

クラウドパートナー
概要クラウドパートナー
OpenTextは、主要なクラウドインフラストラクチャプロバイダーと提携し、OpenTextソリューションをどこでも実行できる柔軟性を提供します。
エンタープライズアプリケーションパートナー
概要エンタープライズアプリケーションパートナー
OpenTextは主要エンタープライズアプリプロバイダーと提携し、非構造化コンテンツを活用してビジネスインサイトを向上
地域を選択してください:
「インシデント予防」とは何でしょうか?
AIOpsとオブザーバビリティが、ITチームがインシデントに単に反応するだけでなく、それを未然に防ぐのにどのように役立つかをご覧ください
概要
インシデント予防とは、事後対応を迅速に行うのではなく、可観測性、サービスコンテキスト、AIを活用して、インシデントがユーザーに届く前に未然に防ぐ取り組みのことです。
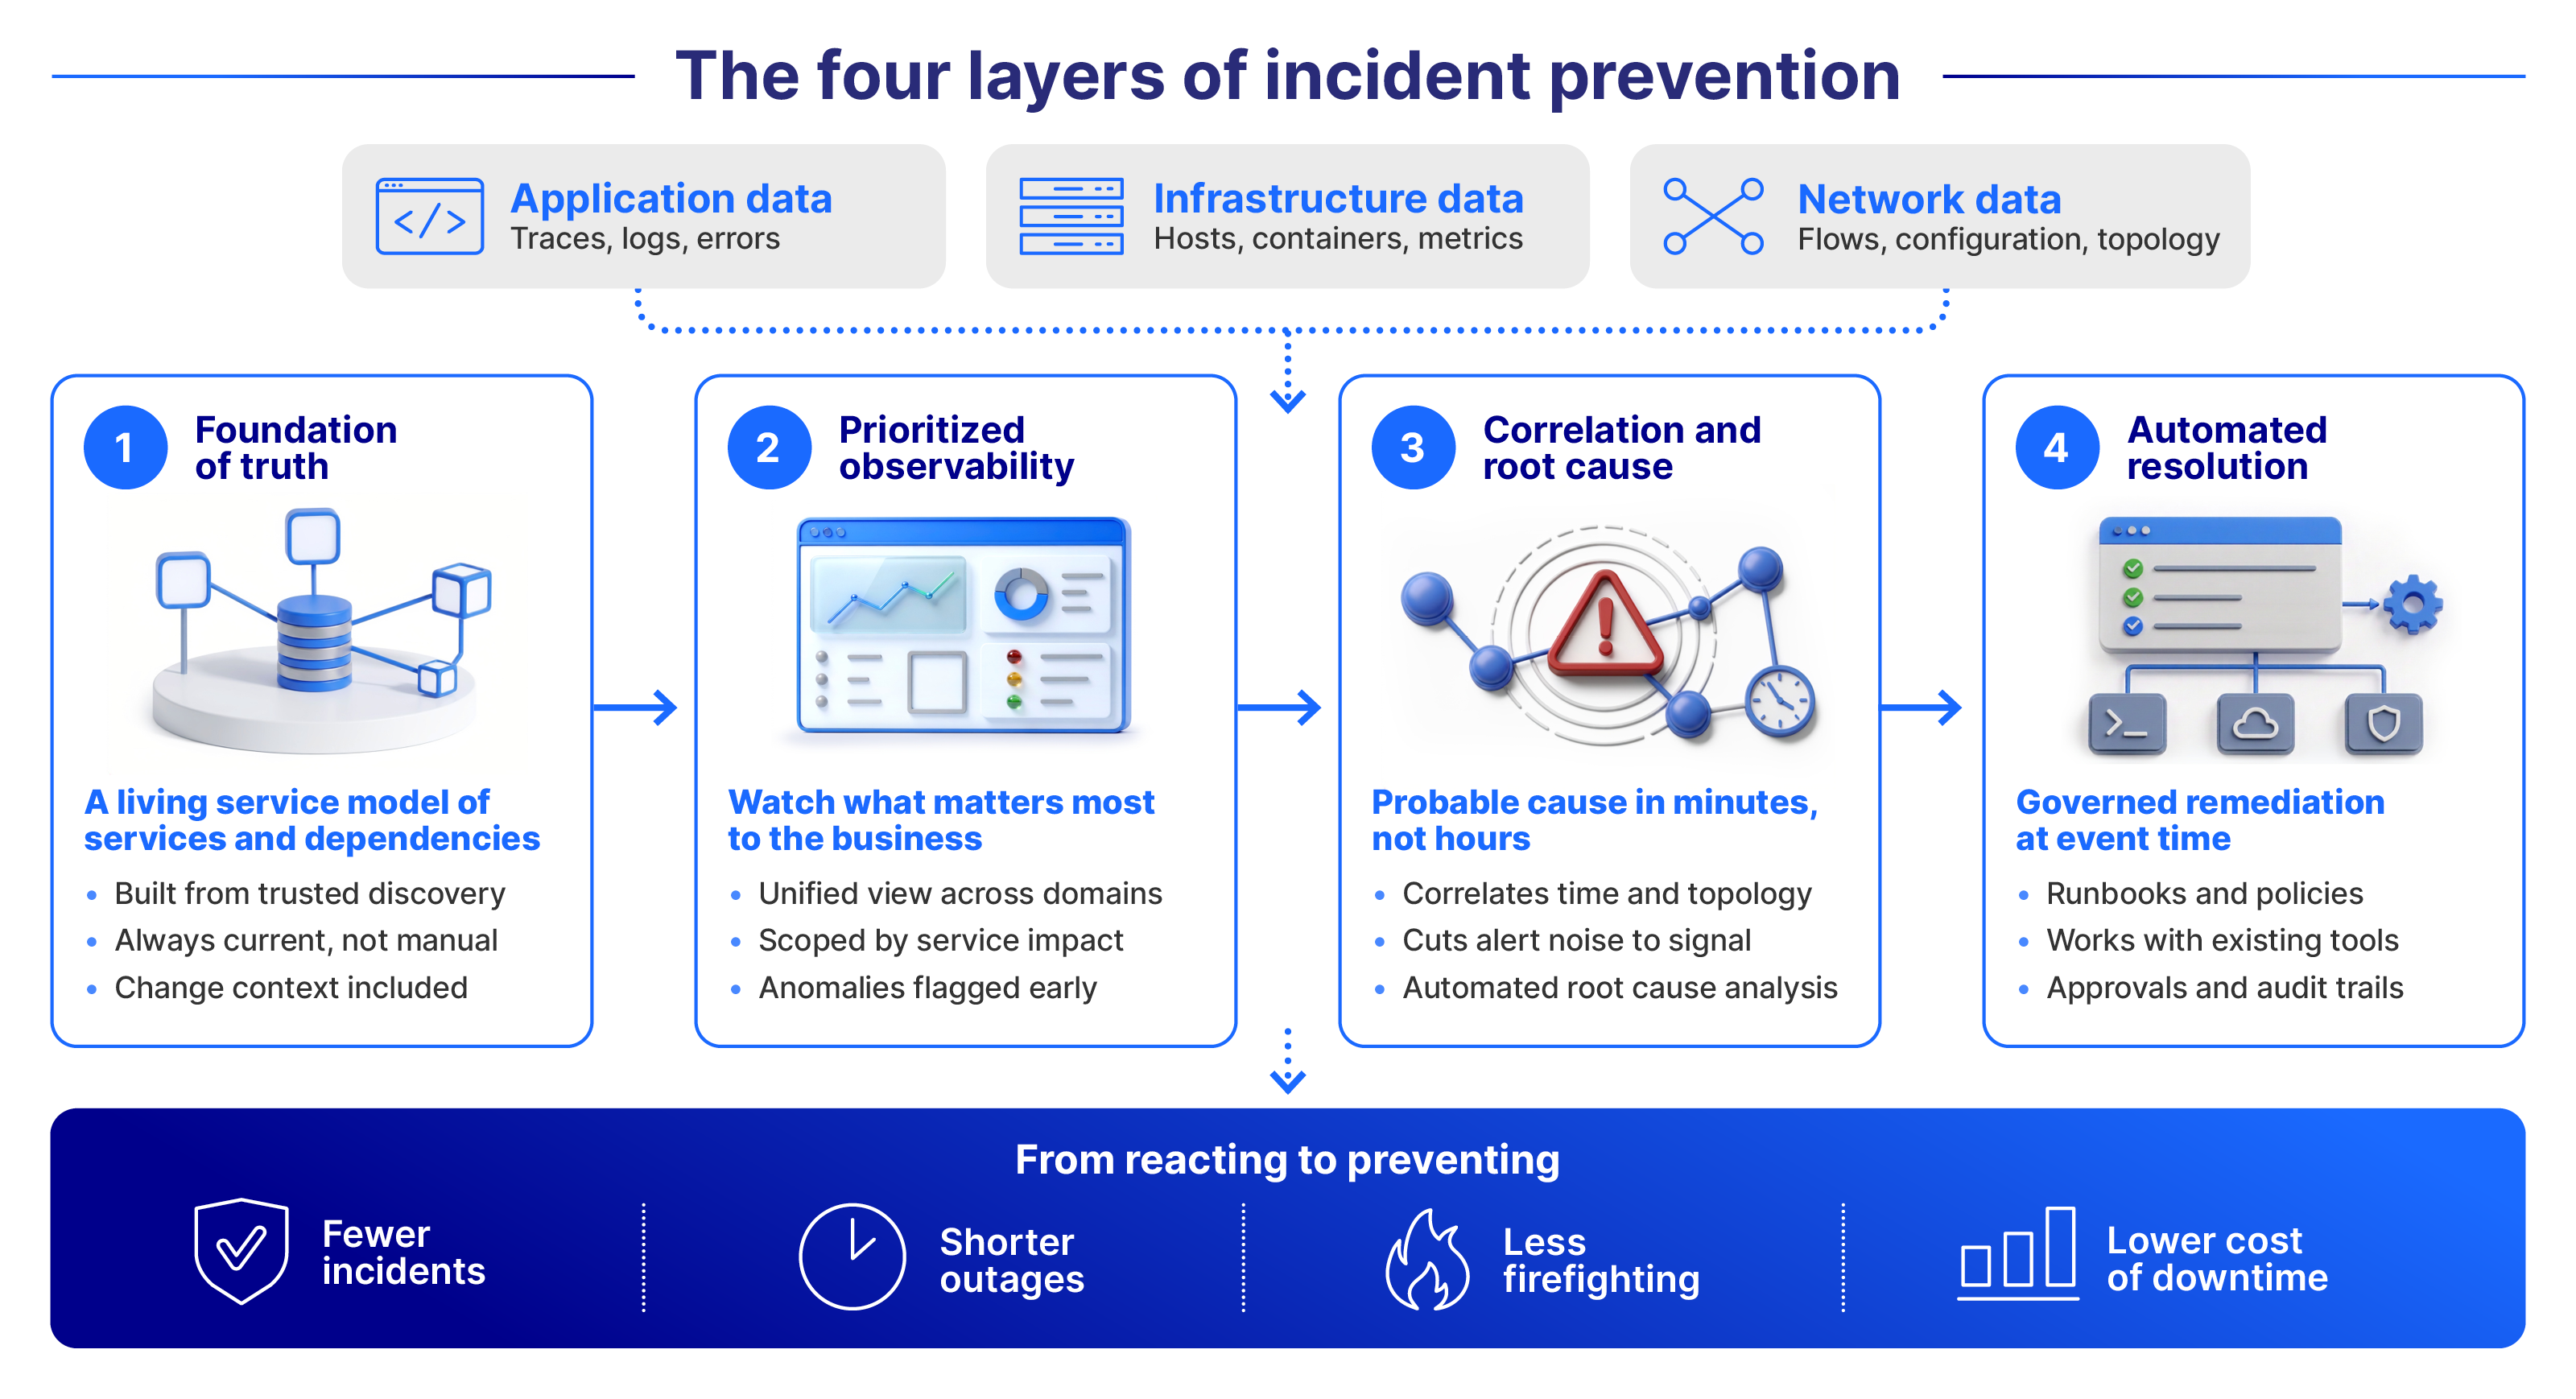
これは4つの能力に基づいており、それぞれの能力は前の能力の上に築かれています:
- 環境中に存在するものを正確に捉えた画像
- 重要な点に焦点を当てたオブザーバビリティ
- 迅速な根本原因の分析
- 管理された自動修復
事故の防止
インシデント予防にはどのようなメリットがありますか?
- ダウンタイムとMTTRを削減:成形上の問題を早期に発見し、根本原因の特定にかかる時間を短縮します。
- チームの負担を軽減しましょう。ウォールームの数を減らし、手作業による相関分析を削減することで、エンジニアはアラートの対応に追われることなく、より付加価値の高い業務に時間を割くことができます。
- セキュリティ体制を強化しましょう:根本原因の分析を迅速化するのと同じ変更および設定のコンテキストにより、不正な変更やリスクのある変更もより迅速に特定できるようになります。
- コンプライアンスの強化:包括的なログ記録と監査証跡により、ITの変更やインシデントに対する管理体制を容易に証明できるようになります。
- 停電によるコストを削減します:インシデントの発生件数が減り、発生時間も短くなることで、収益への影響が軽減され、予定外の人件費も削減されます。
- 自動化への信頼を徐々に築いていきましょう。ガバナンスが施され、人間がプロセスの一部として関与する自動化により、時間の経過とともに自律性を拡大するために必要な信頼を得ることができます。
インシデント防止の4つの層とは何でしょうか?
「予防」は単一の機能ではありません。問題の考えられる原因が分からなければ、その問題を自動的に解決することはできません。適切な観測データがなければ、合理的な疑いを特定することはできません。自分の周囲に何があり、それが何を支えているのかを知らなければ、重要な事柄を観察することはできません。各層は次の層へとつながっています。
- 真実の基盤:アプリケーション、インフラストラクチャ、ネットワーク全体にわたるサービスとその依存関係を網羅した、常に最新の状態が保たれ、簡単に照会できるマップです。これは自動検出に基づいて構築され、手動で管理される記録ではなく、AIによって常に正確な状態が維持されています。この「リビング・サービス」モデルこそが、他のすべての基盤となっています。
- 優先順位付けされた統合型可観測性:どの資産がどのビジネスサービスを支えているかに基づき、最も重要な部分に焦点を絞ったテレメトリ。ここで、閾値に達する前に、成形上の問題が検出されます。
- 相関と根本原因:コンテキスト全体を網羅して推論を行う自動化されたイベント相関機能により、個別のアラートが散在するのではなく、信頼度スコアと追跡可能なロジックとともに、数分以内に考えられる原因を特定します。
- 自動化された解決:ガバナンスが適用されたランブックとポリシーベースの自動化により、シグナルが発生した瞬間に実績のある是正措置を実行します。これには、お客様がすでに運用されているスクリプト、プレイブック、ツールと連携して機能します。
インシデント予防は、従来のインシデント対応とどのように異なるのでしょうか?
従来のIT運用では、MTTR、つまりインシデント発生後の復旧速度によって評価されます。プラットフォームが状況の発生を察知し、数分以内にその原因を特定し、ガバナンスの下で対応できるようになった以上、そのような措置は適切ではありません。インシデントの予防により、評価の基準は「復旧の速さ」から、「そもそもどれだけ多くのインシデントや危機対応室での対応時間を回避できたか」へと変わります。
| 従来の対応 | 事故防止 |
|---|---|
| 障害発生後の検知 | 衝突前に検知する |
| MTTRの重点 | インシデント回避への注力 |
| 事後対応型 | 事前対応型 |
| 手作業による調査 | AIを活用した相関分析 |
AIはインシデントの予防においてどのような役割を果たしているのでしょうか?
AIはインシデント防止のあらゆる段階に関与していますが、その役割は機能によって異なります。
- 検知:機械学習モデルが異常を検知し、関連する事象を関連付けて全体像として把握することで、閾値に達する前に発生しつつある問題を早期に捕捉します。
- 診断:AIは、トポロジー、最近の変更履歴、およびテレメトリ情報を総合的に分析し、考えられる根本原因を特定します。その際、多くの場合、オペレーターが確認・精査できる信頼度スコアが提示されます。
- 解決策:AIは診断結果を自動化と結びつけ、是正措置の手順を発見または作成することができます。多くの組織では、この段階では人間が常にプロセスを監視し、システムへの信頼が高まるにつれて自律性を拡大させています。
プラットフォームによって成熟度は大きく異なります。また、特定のプラットフォーム内においても、AIを活用した診断や問題解決は、まだアラートが発生していない問題の完全自律的な検出に比べて、より進んでいる傾向があります。
インシデントの予防において、ネットワークがなぜ重要なのでしょうか?
インシデントの多くは、このネットワークを起点とするか、あるいはこのネットワークを経由して発生しており、信頼性の高い根本原因分析を行うためには、トランザクションをエンドツーエンドで追跡する必要があります。つまり、ネットワークは単なる付随的な要素ではなく、アプリケーションやインフラストラクチャに次ぐ、基盤となる要素なのです。
また、特に自動解決レイヤーにとっても重要な点です。安全な自動修復には、検証、ロールバック、ポリシーのガードレール、ドリフトの修復、および変更計画の生成といった機能が不可欠であり、これらはネットワーク自動化に組み込まれています。ガートナーの「SREハイプサイクル」では、能動的なネットワーク運用を、ネットワーク自動化の代替ではなく、その強化として位置付けており、その実行基準は、まさにこれらの機能と直接対応しています。簡単に言えば、AIは推論そのものであり、ネットワークの自動化こそが、AIに安全に行動させるための仕組みなのです。
組織は、インシデント防止体制の構築において、どのような課題に直面しているのでしょうか?
- 断片化されたデータ:アプリケーション、インフラストラクチャ、ネットワークのテレメトリデータは、多くの場合、コンテキストが共有されていない別々のツールに分散して管理されています。
- 古いサービス記録:手動で管理されているCMDBは、環境が変化した瞬間に情報が古くなってしまい、その上に構築されたすべての基盤を損なうことになります。
- アラート疲労:ビジネスへの影響度に基づいた優先順位付けが行われないと、チームは重要な事項に対処する前に、大量のノイズに埋もれてしまいます。
- 自動化における信頼の獲得:チームとしては、自動化が正しく、かつ予測可能な形で機能することを確認してからでないと、自動化に任せる範囲を拡大するのは当然のことです。
このプロセスをうまく進めている組織は、まず基盤(最新かつ信頼性の高いサービスモデル)を確立した上で自動化を導入し、自動化の範囲が拡大しても人間の関与を維持し、既存のシステムを全面的に置き換える必要のない、既存のシステムと連携可能なツールを選択する傾向があります。
OpenTextは、インシデントの予防にどのように役立つのでしょうか?
OpenTextは、通信、金融サービス、その他の業界における顧客の実績に裏打ちされ、現在、インシデント防止の4つの層すべてを提供しています。
- OpenText™ AI Operations Managementは、アプリケーション、インフラストラクチャ、ネットワーク全体にわたる可観測性、相関分析、およびガバナンスに基づく自動化を統合します。
- OpenText™ Network Observability」は、実際のサービス停止の大部分が接続性や変更に起因する障害によるものであるため、ネットワークを同じ相関関係のある全体像の中に組み込みます。
- OpenText™ Automation Centerは、診断結果と対応措置を結びつけ、ガバナンスに基づいた是正措置を実行します。
Resources
関連製品
OpenText™ AI Operations Management
IT環境全体において、可観測性を統合し、問題解決を自動化します
OpenText™ Network Observability
ネットワークを、アプリケーションやインフラストラクチャと同様に、相互に関連付けられた全体像の中に組み込む
OpenText™ Automation Center
大規模な自動修復を管理・実行する


