Warum OpenText
Warum OpenText
ÜbersichtWarum OpenText
OpenText verfügt über jahrzehntelange Erfahrung, um Sie dabei zu unterstützen, Daten zu erschließen, Menschen und Prozesse zu verbinden und KI vertrauenswürdig zu machen
Daten verwalten und verbinden
Vereinheitlichen Sie Daten nahtlos im gesamten Unternehmen, um isolierte Bereiche zu verbinden, die Zusammenarbeit zu verbessern und Risiken zu reduzieren.
KI-bereite Informationen
Machen Sie sich bereit für KI und verwandeln Sie Ihre Daten in strukturierte, zugängliche und optimierte Informationen
Integrierte Sicherheit und Compliance
Erfüllen Sie regulatorische und Compliance-Anforderungen und schützen Sie Ihre Informationen während ihres gesamten Lebenszyklus
Menschen befähigen
ÜbersichtMenschen befähigen
OpenText hilft Menschen, Inhalte zu verwalten, Arbeitsabläufe zu automatisieren, KI zu nutzen und zusammenzuarbeiten, um die Produktivität zu steigern
Kunden
Sehen Sie, wie Tausende von Unternehmen auf der ganzen Welt mit innovativen Lösungen von OpenText erfolgreich sind
Mitarbeiter
Unsere Mitarbeiter sind unser größtes Kapital; sie sind das Herz der Marke OpenText und ihrer Werte
Unternehmerische Verantwortung
Erfahren Sie, wie wir gesellschaftliche Ziele vorantreiben und den positiven Wandel beschleunigen wollen
Partner
Finden Sie einen hochqualifizierten OpenText-Partner mit der richtigen Lösung für die digitale Transformation
Setzen Sie das System überall ein
ÜbersichtImplementierungsoptionen
Erkunden Sie skalierbare und flexible Bereitstellungsoptionen für globale Unternehmen jeder Größe
Souveräne Cloud
Lokale Kontrolle. Globaler Maßstab. Vertrauenswürdige KI
Private Cloud
Erschließen Sie den Wert der Cloud und behalten Sie gleichzeitig die Kontrolle und die Compliance
On-Premises-Lösungen
Behalten Sie die volle Kontrolle über Ihre Daten in Ihrer eigenen Infrastruktur
Public Cloud
Schützen, skalieren und nutzen Sie Geschäftsinformationen in der Cloud Ihrer Wahl
KI-Leadership
ÜbersichtAviator AI
Informationen auf neue Weise ansehen
OpenText™ Aviator™
KI, die Ihr Unternehmen, Ihre Daten und Ihre Ziele versteht
OpenText™ Content Aviator™
Leistungsstarke Arbeit mit KI-gestütztem Content-Management und einem intelligenten KI-Content-Assistenten
OpenText™ DevOps Aviator™
Ermöglichen Sie eine schnellere Bereitstellung von Apps, Entwicklung und automatisierte Softwaretests
OpenText™ Experience Aviator™
Verbessern Sie die Kundenkommunikation und das Kundenerlebnis für den Kundenerfolg
OpenText™ Service Management Aviator™
Befähigen Sie Benutzer, Servicemitarbeiter und IT-Personal, die benötigten Antworten zu finden
OpenText™ Trading Grid™ Aviator™
Erschließen Sie KI-gestütztes Wissen, Erkenntnisse und angeleitetes Handeln in Ihrer gesamten Lieferkette
OpenText™ Aviator™ Studio
Ein Ort, an dem Sie Agenten in der Sprache Ihrer Daten erstellen, einsetzen und weiterentwickeln können
OpenText™ Aviator™ AI Services
Professionelle Service-Experten, die Sie auf Ihrer KI-Reise unterstützen
Aviator AI
ÜbersichtAviator AI
Informationen auf neue Weise ansehen
OpenText™ Aviator™
KI, die Ihr Unternehmen, Ihre Daten und Ihre Ziele versteht
OpenText™ Content Aviator™
Leistungsstarke Arbeit mit KI-gestütztem Content-Management und einem intelligenten KI-Content-Assistenten
OpenText™ DevOps Aviator™
Ermöglichen Sie eine schnellere Bereitstellung von Apps, Entwicklung und automatisierte Softwaretests
OpenText™ Experience Aviator™
Verbessern Sie die Kundenkommunikation und das Kundenerlebnis für den Kundenerfolg
OpenText™ Service Management Aviator™
Befähigen Sie Benutzer, Servicemitarbeiter und IT-Personal, die benötigten Antworten zu finden
OpenText™ Trading Grid™ Aviator™
Erschließen Sie KI-gestütztes Wissen, Erkenntnisse und angeleitetes Handeln in Ihrer gesamten Lieferkette
OpenText™ Aviator™ Studio
Ein Ort, an dem Sie Agenten in der Sprache Ihrer Daten erstellen, einsetzen und weiterentwickeln können
OpenText™ Aviator™ AI Services
Professionelle Service-Experten, die Sie auf Ihrer KI-Reise unterstützen
Business Network
ÜbersichtBusiness Network
Einmal verbinden, alles erreichen – mit einer sicheren B2B-Integrationsplattform
Inhalt
ÜbersichtContent
Definieren Sie Ihr Wissen ganz neu mit KI-fähigen Content Management-Lösungen
OpenText™ Content Aviator™(AI)
Optimieren Sie intelligente Arbeitsumgebungen mit KI, um die Arbeitswelt zu modernisieren
Cybersicherheit
ÜbersichtCybersecurity
Integrierte Cybersicherheitslösungen für den Schutz von Unternehmen
DevOps
ÜbersichtDevOps
Liefern Sie bessere Software – schneller – mit KI-gesteuerter DevOps-Automatisierung, Tests und Qualität
OpenText™ DevOps Aviator™(AI)
Unterstützen Sie Millionen von Entwicklern mit KI-gesteuerten DevOps-Erfahrungen
Experience and Fax
ÜbersichtExperience and Fax
Definieren Sie Gespräche mit unvergesslichen Kundenerlebnissen neu
OpenText™ Experience Aviator™(AI)
Gestalten Sie die Kundenkommunikation mit privater generativer KI ganz neu
Legal Tech
ÜbersichtLegal Tech
Treffen Sie intelligentere Entscheidungen mit KI-gestützter juristischer Software und Dienstleistungen
OpenText™ Investigation
Optimieren Sie die Strategie mit frühzeitiger Fallbewertung und Ermittlungswerkzeugen.
OpenText™ Core Insight
Erhalten Sie intelligentere eDiscovery mit fortschrittlichem TAR und automatisierter Dokumentenprüfung.
OpenText™ Core Legal Hold
Automatisieren Sie rechtliche Aufbewahrungen, um risikoreiche und zeitaufwändige Prozesse zu eliminieren.
OpenText™ Legal Knowledge Management
Erschließen Sie Wissen und rechtliche Einblicke über Inhaltssilos hinweg
Beobachtbarkeit und Servicemanagement
ÜbersichtObservability and Service Management
Verschaffen Sie sich die nötige Klarheit, um die Kosten und die Komplexität des IT-Betriebs zu reduzieren
OpenText™ Service Management Aviator™(AI)
Definieren Sie Tier 1-Supportfunktionen mit Self-Service-Fähigkeiten aus privater generativer KI neu
APIs
ÜbersichtAPIs
Extend the value of your OpenText solutions by building integrations, automation and custom experiences
OpenText™ API Services
Erstellen Sie Ihre eigene Lösung mit OpenText Cloud APIs. Mit diesen APIs erstellen Sie Echtzeit-Informationsflüsse, die benutzerdefinierte Anwendungen und Workflows ermöglichen.
Device and Data Protection
ÜbersichtDevice and Data Protection
Schützen, was wichtig ist, wiederherstellen, wenn es darauf ankommt
Lösungen
Vertrauenswürdige Daten und KI
ÜbersichtVertrauenswürdige Daten und KI
Sicheres Informationsmanagement trifft auf vertrauenswürdige KI
OpenText™ Aviator™ Studio
Ein Ort, an dem Sie Agenten in der Sprache Ihrer Daten erstellen, einsetzen und weiterentwickeln können
OpenText™ Discovery
Ein Satz von Tools zur Unterstützung der Datenaufnahme und zur Automatisierung der Metadaten-Tagging-Prozesse, um KI zu fördern
OpenText™ Data Compliance
Eine Suite von Diensten und APIs, die proaktive und dauerhafte Governance ermöglichen
OpenText™ Aviator™ AI Services
Professionelle Service-Experten, die Sie auf Ihrer KI-Reise unterstützen
Informationen neu gedacht
ÜbersichtInformationen neu gedacht
Profitieren Sie von mehr Transparenz und präziseren Erkenntnissen durch KI-gestütztes Informationsmanagement. Möchten Sie sehen, wie?
Wissen neu interpretiert
Transformieren Sie die tägliche Arbeit mit KI-gestütztem Enterprise Content Management
Servicemanagement neu gedacht
Reduzieren Sie die Kosten und Komplexität von IT-Servicemanagement, AIOps und Observability
Verbindungen neu gedacht
KI-gestützte B2B-Integration für eine erfolgreiche Lieferkette
Gespräche neu gedacht
Steigern Sie Wert, Wachstum und Kundenloyalität durch vernetzte Kundenerlebnisse
Engineering neu gedacht
Agile Entwicklung und Softwarebereitstellung? Es scheint nur unmöglich
Sicherheit neu definiert
Cybersicherheit für Unternehmen
Entscheidungen neu gedacht
Entdecken Sie Erkenntnisse mit KI-Datenanalysen
Künstliche Intelligenz
ÜbersichtAviator AI
Informationen auf neue Weise ansehen
OpenText™ Aviator™
KI, die Ihr Unternehmen, Ihre Daten und Ihre Ziele versteht
OpenText™ Content Aviator™
Leistungsstarke Arbeit mit KI-gestütztem Content-Management und einem intelligenten KI-Content-Assistenten
OpenText™ DevOps Aviator™
Ermöglichen Sie eine schnellere Bereitstellung von Apps, Entwicklung und automatisierte Softwaretests
OpenText™ Experience Aviator™
Verbessern Sie die Kundenkommunikation und das Kundenerlebnis für den Kundenerfolg
OpenText™ Service Management Aviator™
Befähigen Sie Benutzer, Servicemitarbeiter und IT-Personal, die benötigten Antworten zu finden
OpenText™ Trading Grid™ Aviator™
Erschließen Sie KI-gestütztes Wissen, Erkenntnisse und angeleitetes Handeln in Ihrer gesamten Lieferkette
OpenText™ Aviator™ Studio
Ein Ort, an dem Sie Agenten in der Sprache Ihrer Daten erstellen, einsetzen und weiterentwickeln können
OpenText™ Aviator™ AI Services
Professionelle Service-Experten, die Sie auf Ihrer KI-Reise unterstützen
Branche
ÜbersichtBranchenlösungen
Verbessern Sie Effizienz, Sicherheit und Kundenzufriedenheit mit OpenText
Energie und Ressourcen
Transformieren Sie die Energie- und Ressourcenprozesse mit Cloud, Cybersicherheit und KI
Finanzdienstleistungen
Steigern Sie Kundenerlebnis, Compliance und Effizienz mit KI
Regierung
Denken Sie Ihre Mission mit regierungssicherem Informationsmanagement neu
Gesundheitswesen und Lebenswissenschaften
Verbessern Sie die Versorgung und die Patientenbindung mit KI-gestützten Lösungen
Rechtswesen
Modernisieren Sie juristische Teams mit automatisierten, KI-gestützten Legal-Tech-Lösungen
Fertigung
Modernisieren Sie Fertigungsprozesse und Logistik, um Kosten zu senken und die Compliance zu gewährleisten
Einzelhandel und Konsumgüter
Verbessern Sie die Verbraucherbindung mit Omnichannel-Retail-Lösungen und KI
Unternehmensanwendung
ÜbersichtLösungen für Unternehmensanwendungen
Prozesse schneller und mit geringerem Risiko ausführen
Maximieren Sie nachhaltiges Wachstum, Wertschöpfung und Innovation mit intelligenten Unternehmenslösungen von OpenText und SAP
Verknüpfen Sie Inhalte mit Geschäftsprozessen, um die Produktivität zu steigern und die Governance zu verbessern
Optimieren Sie die Effektivität von Salesforce, indem Sie transaktionale Daten und unstrukturierte Inhalte zusammenführen
Services
Services
ÜbersichtServices
Beschleunigen Sie die digitale Transformation mit Anleitung von zertifizierten Experten
Professional Services
Modernisieren Sie Ihr Informationsmanagement mit zertifizierten Experten
Customer Success Services
Erreichen Sie Geschäftsziele mit Expertenberatung, Managed Services und mehr.
Support Services
Verwandeln Sie den Support in Ihren strategischen Vorteil
Managed Services
Entlasten Sie Ihre internen Teams mit fachkundigem IT-Servicemanagement
Learning Services
Informieren Sie sich über die Schulungsmöglichkeiten, die Anwendern aller Qualifikationsstufen helfen, OpenText-Produkte effektiv einzusetzen und zu nutzen
Professional Services
ÜbersichtProfessional Services
Modernisieren Sie Ihr Informationsmanagement mit zertifizierten Experten
Customer Success Services
ÜbersichtCustomer Success Services
Erreichen Sie Geschäftsziele mit Expertenberatung, Managed Services und mehr.
Support Services
ÜbersichtSupport Services
Verwandeln Sie den Support in Ihren strategischen Vorteil
Managed Services
ÜbersichtManaged Services
Entlasten Sie Ihre internen Teams mit fachkundigem IT-Servicemanagement
Learning Services
ÜbersichtLearning Services
Informieren Sie sich über die Schulungsmöglichkeiten, die Anwendern aller Qualifikationsstufen helfen, OpenText-Produkte effektiv einzusetzen und zu nutzen
Partner
Finden Sie einen Partner
ÜbersichtFinden Sie einen Partner
Finden Sie einen hochqualifizierten OpenText-Partner mit der richtigen Lösung für die digitale Transformation

Cloud-Partner
ÜbersichtCloud-Partner
OpenText arbeitet mit führenden Cloud-Infrastruktur-Anbietern zusammen, um die Flexibilität zu bieten, OpenText-Lösungen überall auszuführen
Optimieren Sie die Leistung und senken Sie die Kosten mit Anwendungen, die auf einer sicheren, global skalierbaren Plattform bereitgestellt werden
Beschleunigung von Migration und Modernisierung durch Bereitstellung in einer hochsicheren und konformen Public Cloud
Partner für Unternehmensanwendungen
ÜbersichtPartner für Unternehmensanwendungen
OpenText arbeitet mit führenden Anbietern von Unternehmens-Apps zusammen, um unstrukturierte Inhalte für bessere Geschäftseinblicke freizuschalten
Maximieren Sie nachhaltiges Wachstum, Wertschöpfung und Innovation mit intelligenten Unternehmenslösungen von OpenText und SAP
Verknüpfen Sie Inhalte mit Geschäftsprozessen, um die Produktivität zu steigern und die Governance zu verbessern
Optimieren Sie die Effektivität von Salesforce, indem Sie transaktionale Daten und unstrukturierte Inhalte zusammenführen
Partnerlösungen
ÜbersichtPartnerlösungen
Informieren Sie sich über flexible und innovative Angebote, die einen Mehrwert für OpenText-Lösungen bieten
Ressourcen für Partner
ÜbersichtRessourcen für Partner
Entdecken Sie die verfügbaren Ressourcen zur Unterstützung und zum Ausbau der Fähigkeiten von Partnern
Support
ÜbersichtKundensupport
Erhalten Sie fachkundigen Produkt- und Service-Support, um die Lösung von Problemen zu beschleunigen und die Geschäftsabläufe effizient zu halten
Ressourcen
ÜbersichtRessourcen
Entdecken Sie detaillierte Dienstleistungen und Beratungspräsentationen, Briefings, Dokumentationen und weitere Ressourcen
Wählen Sie Ihre Region:
Nord-, Mittel- und Südamerika
Europa, Naher Osten und Afrika
Asien-Pazifik-Raum
Was versteht man unter Vorfallprävention?
Erfahren Sie, wie AIOps und Observability IT-Teams dabei helfen, Vorfälle zu verhindern, anstatt nur auf sie zu reagieren
Übersicht
Unter Vorfallprävention versteht man den Einsatz von Observability, Servicekontext und KI, um Vorfälle zu verhindern, bevor sie die Nutzer erreichen, anstatt sie im Nachhinein schneller zu beheben.
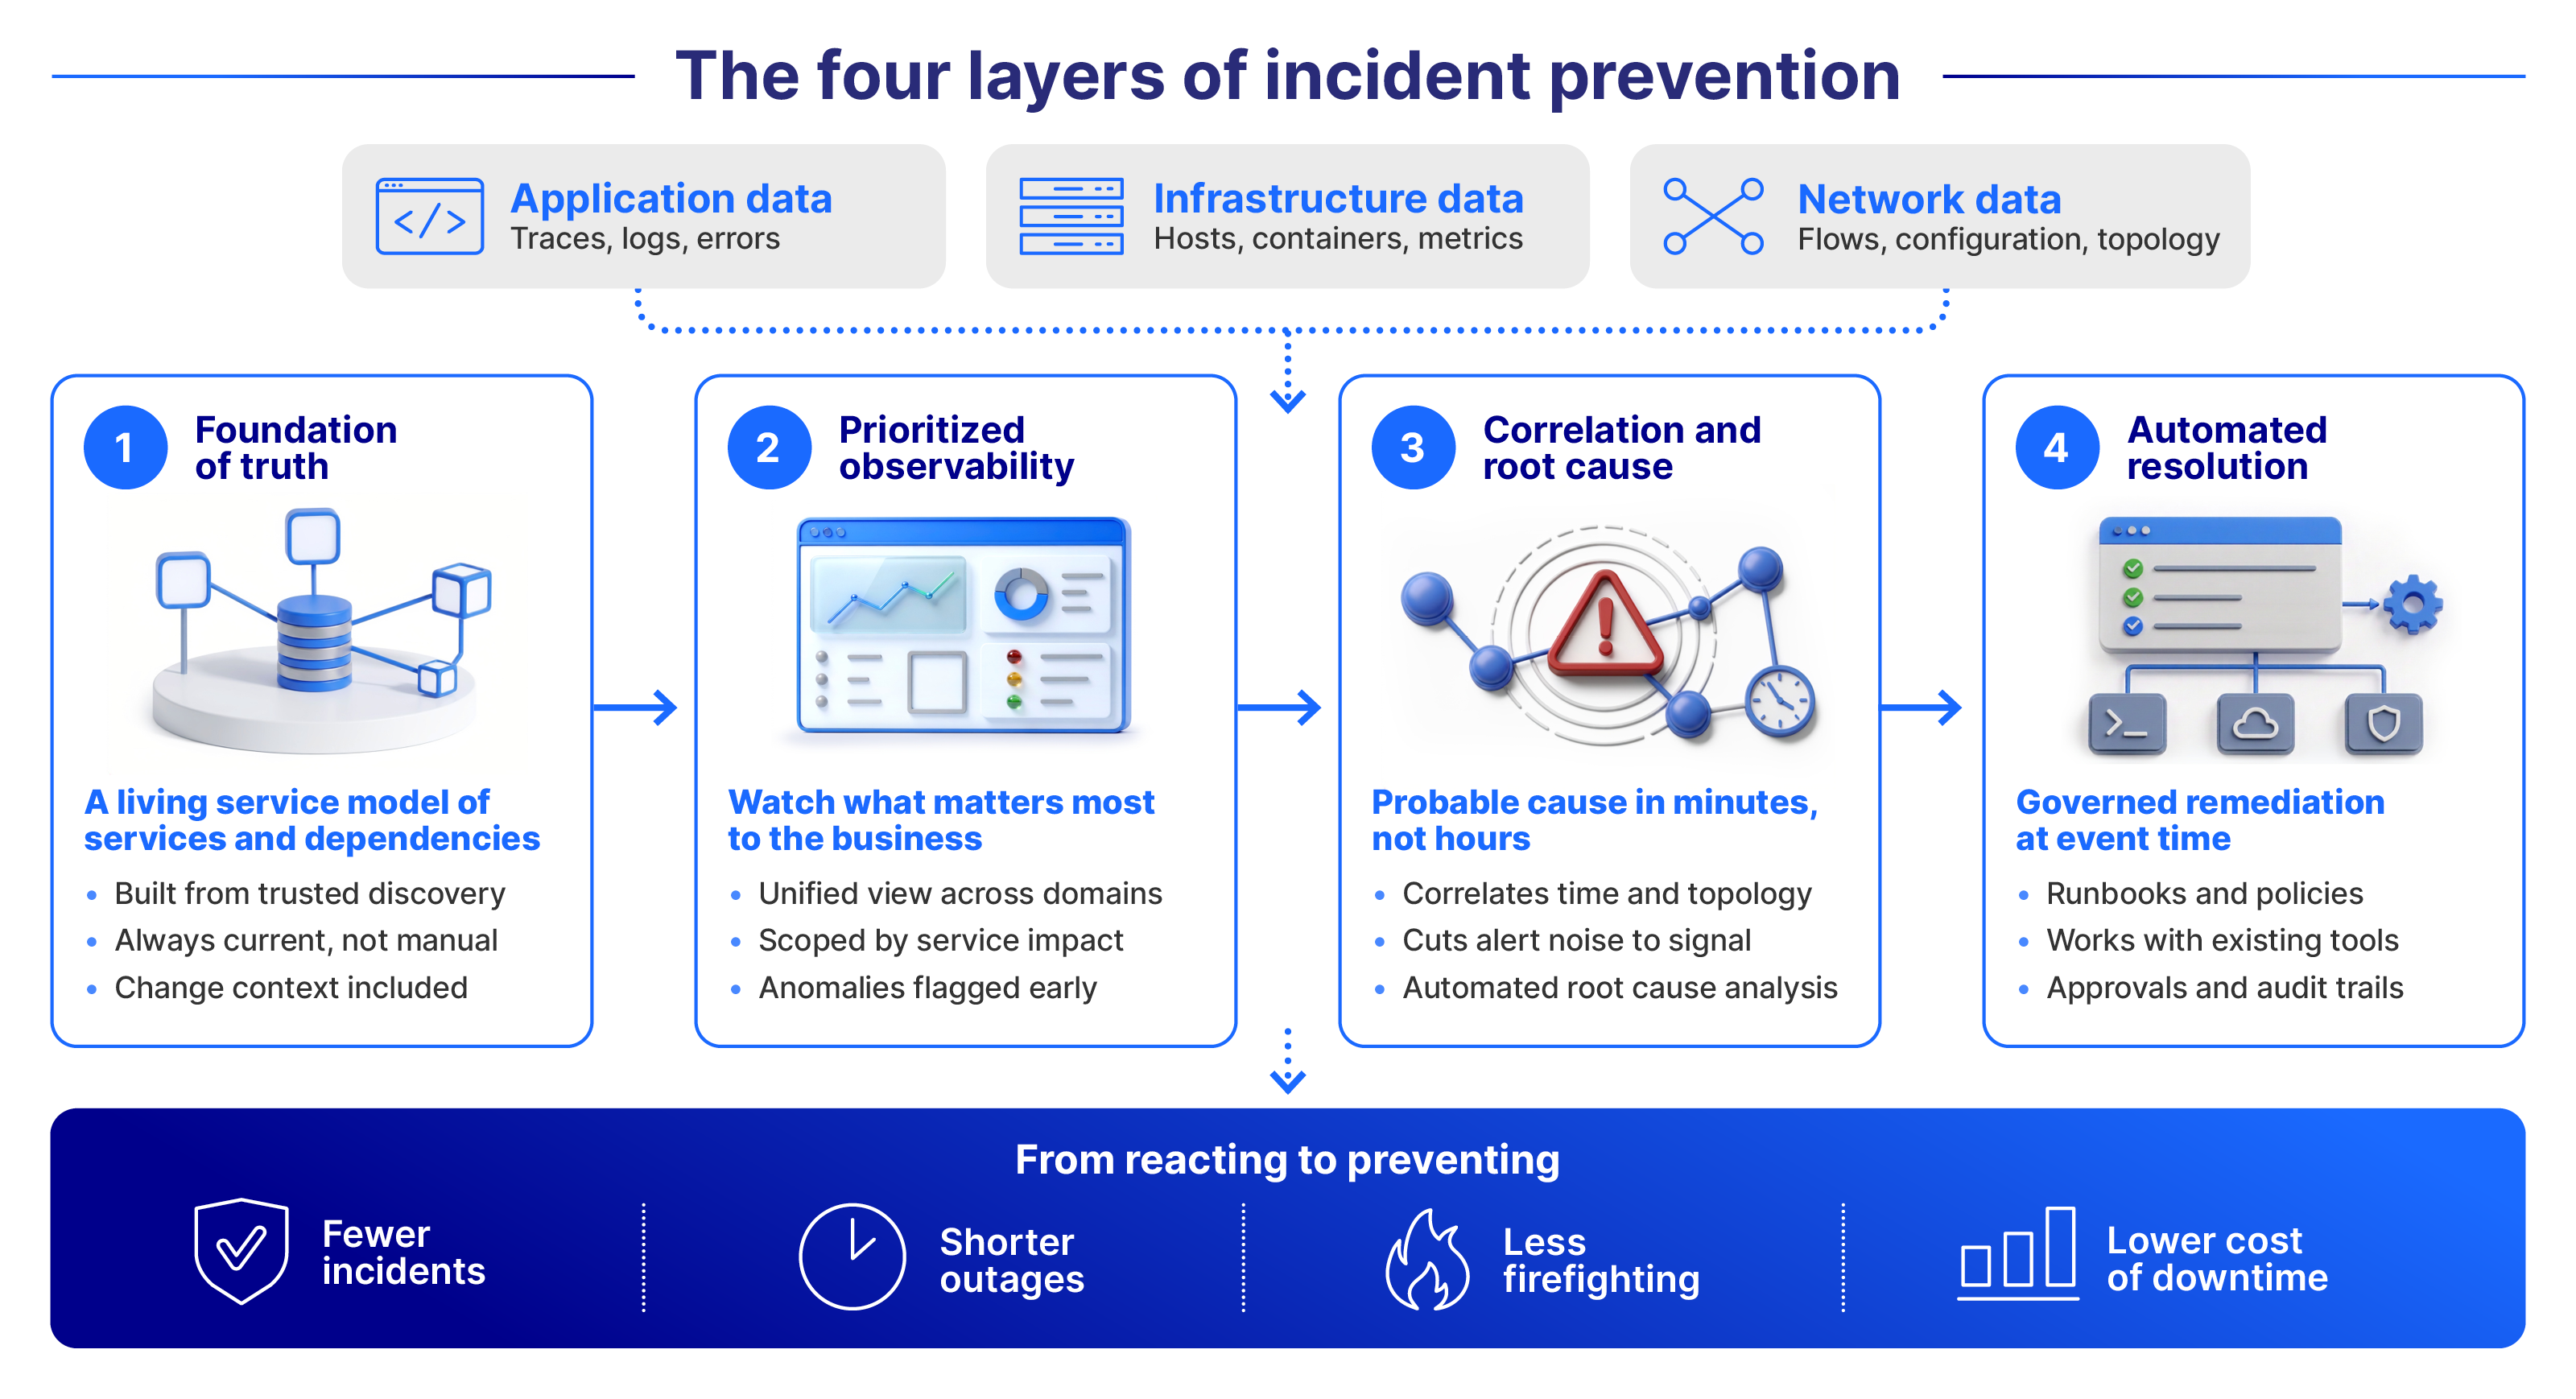
Es basiert auf vier Kompetenzen, von denen jede auf der vorherigen aufbaut:
- Ein verlässliches Bild davon, was in der Umgebung vorhanden ist
- Observability mit Fokus auf das Wesentliche
- Schnelle Ursachenanalyse
- Kontrollierte automatisierte Fehlerbehebung
Prävention von Zwischenfällen
Welche Vorteile bietet die Vorbeugung von Vorfällen?
- Verringern Sie Ausfallzeiten und die MTTR: Erkennen Sie Formprobleme frühzeitig und verkürzen Sie die Zeit, die für die Ermittlung der Ursache aufgewendet wird.
- Entlasten Sie Ihr Team: Weniger „War Rooms“ und weniger manuelle Korrelation bedeuten, dass sich die Ingenieure auf wertschöpfendere Aufgaben konzentrieren können, anstatt Alarme nachzugehen.
- Stärken Sie Ihre Sicherheitslage: Derselbe Änderungs- und Konfigurationskontext, der die Ursachenanalyse beschleunigt, deckt auch unbefugte oder risikobehaftete Änderungen schneller auf.
- Verbesserung der Compliance: Umfassende Protokollierung und Prüfpfade erleichtern den Nachweis der Kontrolle über IT-Änderungen und Vorfälle.
- Senkung der Kosten durch Betriebsausfälle: Weniger und kürzere Vorfälle bedeuten geringere Auswirkungen auf den Umsatz und geringere ungeplante Personalkosten.
- Bauen Sie schrittweise Vertrauen in die Automatisierung auf: Eine kontrollierte Automatisierung, bei der der Mensch stets in den Prozess eingebunden bleibt, schafft das nötige Vertrauen, um die Autonomie im Laufe der Zeit auszuweiten.
Welche vier Ebenen der Vorfallprävention gibt es?
Prävention ist keine einzelne Funktion. Sie können ein Problem nicht automatisch beheben, ohne dessen wahrscheinliche Ursache zu kennen. Ohne die richtigen Observability-Daten können Sie keine hinreichenden Verdachtsgründe ermitteln. Sie können nicht beobachten, was wichtig ist, ohne zu wissen, was in Ihrer Umgebung vorhanden ist und was diese ermöglicht. Jede Ebene bildet die Grundlage für die nächste.
- Grundlage der Wahrheit: Eine stets aktuelle, leicht abfragbare Übersicht über Dienste und deren Abhängigkeiten über Anwendungen, Infrastruktur und das Netzwerk hinweg, die auf der Basis von Erkennungsprozessen erstellt und durch KI auf dem neuesten Stand gehalten wird, anstatt manuell gepflegt zu werden. Dieses Modell der Lebensbegleitung ist die Grundlage, auf der alles andere aufbaut.
- Priorisierte, integrierte Beobachtbarkeit: Telemetrie, die sich auf das Wesentliche konzentriert, basierend darauf, welche Ressourcen welche Geschäftsdienste unterstützen. An dieser Stelle werden auftretende Probleme bereits erkannt, bevor ein Schwellenwert überschritten wird.
- Korrelation und Grundursache: Automatisierte Ereigniskorrelation, die den gesamten Kontext berücksichtigt, um innerhalb weniger Minuten wahrscheinliche Ursachen zu ermitteln – mit Konfidenzwerten und nachvollziehbarer Logik anstelle einer Vielzahl einzelner Warnmeldungen.
- Automatisierte Fehlerbehebung: Reglementierte, auf Runbooks und Richtlinien basierende Automatisierung, die bewährte Korrekturmaßnahmen unmittelbar nach dem Auftreten eines Signals ausführt und dabei mit den Skripten, Playbooks und Tools arbeitet, die Sie bereits einsetzen.
Erfahren Sie, warum die Vorbeugung von Vorfällen wichtig ist
Inwiefern unterscheidet sich die Vorbeugung von Vorfällen von der herkömmlichen Reaktion auf Vorfälle?
Herkömmliche IT-Betriebsabläufe werden anhand der MTTR bewertet, d. h. danach, wie schnell Sie nach dem Auftreten eines Vorfalls den Normalbetrieb wiederherstellen können. Das ist die falsche Vorgehensweise, sobald eine Plattform erkennen kann, wie sich bestimmte Situationen entwickeln, innerhalb weniger Minuten einen hinreichenden Verdacht benennen und im Rahmen der Governance entsprechend handeln kann. Bei der Vorbeugung von Vorfällen geht es nicht mehr darum, wie schnell Sie Probleme beheben, sondern darum, wie viele Vorfälle und wie viele Stunden in der Krisenzentrale Sie von vornherein vermeiden können.
| Traditionelle Reaktion | Prävention von Zwischenfällen |
|---|---|
| Erkennung nach einem Ausfall | Erkennen, bevor es zum Aufprall kommt |
| Schwerpunkt MTTR | Schwerpunkt auf der Vermeidung von Zwischenfällen |
| Reaktiv | Proaktiv |
| Manuelle Untersuchung | KI-gestützte Korrelation |
Welche Rolle spielt künstliche Intelligenz bei der Vorbeugung von Vorfällen?
Künstliche Intelligenz durchdringt alle Ebenen der Vorfallprävention, wobei ihre Rolle je nach Funktionsbereich unterschiedlich ist.
- Erkennung: Modelle des maschinellen Lernens weisen auf Anomalien hin und verknüpfen damit zusammenhängende Ereignisse zu einem Gesamtbild, wodurch sich abzeichnende Probleme erkannt werden, bevor ein Schwellenwert überschritten wird.
- Diagnose: Die KI wertet Topologie, aktuelle Änderungen und Telemetriedaten aus, um die wahrscheinliche Grundursache zu ermitteln, häufig mit einem Konfidenzwert, den ein Bediener hinterfragen und verfeinern kann.
- Lösung: KI kann eine Diagnose mit Automatisierungsmaßnahmen verknüpfen und dabei Abhilfemaßnahmen ermitteln oder erstellen. Die meisten Organisationen beziehen in dieser Phase weiterhin einen Menschen mit ein und erweitern die Autonomie in dem Maße, wie das Vertrauen in das System wächst.
Der Reifegrad variiert erheblich zwischen den verschiedenen Plattformen, und selbst innerhalb einer bestimmten Plattform sind KI-gestützte Diagnose und Problemlösung in der Regel weiter fortgeschritten als die vollständig autonome Erkennung von Problemen, die noch keinen Alarm ausgelöst haben.
Warum spielt das Netzwerk bei der Vorbeugung von Vorfällen eine Rolle?
Ein großer Teil der Vorfälle hat seinen Ursprung im Netzwerk oder läuft über dieses, und eine Ursachenanalyse muss eine Transaktion von Anfang bis Ende nachverfolgen, um aussagekräftig zu sein. Damit wird das Netzwerk zu einer grundlegenden Komponente und nicht zu einem nachrangigen Aspekt hinter Anwendungen und Infrastruktur.
Dies ist insbesondere auch für die Ebene der automatisierten Problemlösung von Bedeutung. Eine sichere automatisierte Fehlerbehebung hängt von Funktionen wie Verifizierung, Rollback, Richtlinienvorgaben, Behebung von Abweichungen und der Erstellung von Änderungsplänen ab – allesamt Funktionen, die Teil der Netzwerkautomatisierung sind. Gartners „Hype Cycle“ für SRE betrachtet den agentenbasierten Netzwerkbetrieb als Erweiterung der Netzwerkautomatisierung und nicht als deren Ersatz, und die dort genannten Umsetzungskriterien beziehen sich direkt auf eben diese Fähigkeiten. Einfach ausgedrückt: Die KI steht für das logische Denken; die Netzwerkautomatisierung ermöglicht es ihr, sicher zu handeln.
Vor welchen Herausforderungen stehen Unternehmen beim Aufbau von Maßnahmen zur Vorbeugung von Vorfällen?
- Fragmentierte Daten: Anwendungs-, Infrastruktur- und Netzwerktelemetriedaten werden häufig in separaten Tools erfasst, ohne dass ein gemeinsamer Kontext besteht.
- Veraltete Service-Datensätze: Eine manuell gepflegte CMDB ist in dem Moment veraltet, in dem sich die Umgebung ändert, was alles untergräbt, was darauf aufbaut.
- Alarmmüdigkeit: Ohne eine Priorisierung, die sich an den geschäftlichen Auswirkungen orientiert, gehen die Teams im Informationsrauschen unter, noch bevor sie auf das Wesentliche reagieren können.
- Vertrauen in die Automatisierung gewinnen: Teams möchten verständlicherweise zunächst sicherstellen, dass die Automatisierung korrekt und vorhersehbar funktioniert, bevor sie den Umfang der Aufgaben erweitern, die sie eigenständig ausführen darf.
Unternehmen, die diesen Ansatz gut umsetzen, beginnen in der Regel mit der Grundlage (einem aktuellen, zuverlässigen Servicemodell), bevor sie Automatisierungsebenen hinzufügen; sie beziehen den Menschen weiterhin in den Prozess ein, wenn der Umfang der Automatisierung zunimmt, und wählen Tools, die sich in ihre bestehenden Systeme integrieren lassen, anstatt eine vollständige Erneuerung zu erfordern.
Inwiefern kann OpenText zur Vorbeugung von Vorfällen beitragen?
OpenText deckt bereits heute alle vier Ebenen der Vorfallprävention ab, was durch Kundenergebnisse in der Telekommunikationsbranche, im Finanzdienstleistungssektor und in anderen Branchen belegt wird.
- OpenText™ AI Operations Management vereint Observability, Korrelation und kontrollierte Automatisierung über Anwendungen, Infrastruktur und das Netzwerk hinweg.
- OpenText™ Network Observability bindet das Netzwerk in dasselbe korrelierte Gesamtbild ein, da Konnektivitätsprobleme und durch Änderungen verursachte Ausfälle einen großen Anteil an den tatsächlichen Ausfällen ausmachen.
- OpenText™ Automation Center führt kontrollierte Korrekturmaßnahmen durch und verbindet so die Diagnose mit dem entsprechenden Handeln.
Resources
Verwandte Produkte
OpenText™ AI Operations Management
Vereinheitlichen Sie die Überwachbarkeit und automatisieren Sie die Fehlerbehebung in Ihrer gesamten IT-Infrastruktur
OpenText™ Network Observability
Das Netzwerk in dasselbe zusammenhängende Gesamtbild wie Anwendungen und Infrastruktur einbinden
OpenText™ Automation Center
Steuerung und Durchführung automatisierter Korrekturmaßnahmen in großem Maßstab


