Por que escolher a OpenText
Por que escolher a OpenText
Visão geralPor que escolher a OpenText
A OpenText traz décadas de experiência para ajudar você a desbloquear dados, conectar pessoas e processos e alimentar a IA com confiança
Gerenciar e conectar dados
Unifique os dados de forma integrada em toda a sua empresa para eliminar silos, melhorar a colaboração e reduzir riscos
Informação pronta para IA
Prepare-se para a IA e transforme seus dados em informações estruturadas, acessíveis e otimizadas
Segurança e conformidade integradas
Atenda aos requisitos regulatórios e de conformidade e proteja suas informações durante todo o seu ciclo de vida
Empoderamento de pessoas
Visão geralEmpoderamento de pessoas
A OpenText ajuda as pessoas a gerenciar conteúdo, automatizar o trabalho, usar IA e colaborar para aumentar a produtividade
Clientes
Veja como milhares de empresas ao redor do mundo estão obtendo sucesso com soluções inovadoras da OpenText
Funcionários
Nosso povo é nosso maior patrimônio; eles são a vida da marca e dos valores da OpenText
Responsabilidade Corporativa
Saiba como aspiramos avançar nos objetivos sociais e acelerar mudanças positivas
Parceiros
Encontre um parceiro OpenText altamente qualificado com a solução certa para viabilizar a transformação digital
Implante em qualquer lugar
Visão geralOpções de implantação
Explore opções de implantação escaláveis e flexíveis para organizações globais de qualquer tamanho
Nuvem soberana
Controle local. Escala global. IA Confiável
Nuvem privada
Desbloqueie o valor da nuvem e mantenha o controle e a conformidade
No local
Mantenha o controle total de seus dados em sua própria infraestrutura
Nuvem pública
Proteja, dimensione e use informações comerciais na nuvem de sua preferência
Liderança em IA
Visão geralAviator AI
Veja informações de novas maneiras
OpenText™ Aviator™
IA que entende o seu negócio, os seus dados e os seus objetivos
OpenText™ Content Aviator™
Potencialize o trabalho com gerenciamento de conteúdo por IA e um assistente inteligente de conteúdo com IA
OpenText™ DevOps Aviator™
Permitir entrega mais rápida de aplicativos, desenvolvimento e testes automatizados de software
OpenText™ Experience Aviator™
Melhore a comunicação e as experiências dos clientes para o sucesso do cliente
OpenText™ Service Management Aviator™
Capacite usuários, agentes de serviço e equipe de TI a encontrar as respostas de que precisam
OpenText™ Trading Grid™ Aviator™
Desbloqueie conhecimentos, insights e ações guiadas por IA em toda a sua cadeia de suprimentos
OpenText™ Aviator™ Studio
Um lugar onde você pode criar, implantar e iterar agentes na linguagem dos seus dados
OpenText™ Aviator™ AI Services
Especialistas em serviços profissionais que ajudam você na sua jornada de IA
Aviator AI
Visão geralAviator AI
Veja informações de novas maneiras
OpenText™ Aviator™
IA que entende o seu negócio, os seus dados e os seus objetivos
OpenText™ Content Aviator™
Potencialize o trabalho com gerenciamento de conteúdo por IA e um assistente inteligente de conteúdo com IA
OpenText™ DevOps Aviator™
Permitir entrega mais rápida de aplicativos, desenvolvimento e testes automatizados de software
OpenText™ Experience Aviator™
Melhore a comunicação e as experiências dos clientes para o sucesso do cliente
OpenText™ Service Management Aviator™
Capacite usuários, agentes de serviço e equipe de TI a encontrar as respostas de que precisam
OpenText™ Trading Grid™ Aviator™
Desbloqueie conhecimentos, insights e ações guiadas por IA em toda a sua cadeia de suprimentos
OpenText™ Aviator™ Studio
Um lugar onde você pode criar, implantar e iterar agentes na linguagem dos seus dados
OpenText™ Aviator™ AI Services
Especialistas em serviços profissionais que ajudam você na sua jornada de IA
Rede de Negócios
Visão geralBusiness Network
Conecte-se uma vez, alcance qualquer coisa com uma plataforma segura de integração B2B
Conteúdo
Visão geralContent
Reimagine o conhecimento com soluções de gestão de conteúdo preparadas para IA
OpenText™ Content Aviator™(IA)
Turbine espaços de trabalho inteligentes com IA para modernizar o trabalho
Segurança cibernética
Visão geralCybersecurity
Soluções integradas de cibersegurança para proteção empresarial
OpenText Cibersegurança para PMEs e MSPs
Soluções de proteção e segurança de dados desenvolvidas especificamente
DevOps
Visão geralDevOps
Distribua softwares melhores — mais rápido — com automação, testes e qualidade DevOps impulsionados por IA
OpenText™ DevOps Aviator™(IA)
Elevar milhões de desenvolvedores com experiências DevOps impulsionadas por IA
Experience and Fax
Visão geralExperience and Fax
Reimagine conversas com experiências inesquecíveis para clientes
Tecnologia Jurídica
Visão geralLegal Tech
Tome decisões mais inteligentes com software e serviços jurídicos baseados em IA
OpenText™ Investigation
Otimize a estratégia com ferramentas de avaliação antecipada e investigação de casos
OpenText™ Core Insight
Obtenha uma eDiscovery mais inteligente com TAR avançado e revisão automatizada de documentos
OpenText™ Core Legal Hold
Automatizar retenções legais para eliminar processos arriscados e demorados
OpenText™ Legal Knowledge Management
Desbloqueie conhecimento e insights jurídicos entre silos de conteúdo
Observabilidade e Gestão de Serviços
Visão geralObservability and Service Management
Obtenha a clareza necessária para reduzir o custo e a complexidade das operações de TI
OpenText™ Service Management Aviator™(IA)
Redefinir funções de suporte empresarial de Nível 1 com capacidades de autoatendimento de IA generativa privada
APIs
Visão geralAPIs
Extend the value of your OpenText solutions by building integrations, automation and custom experiences
OpenText™ API Services
Construa do seu jeito com as APIs da OpenText Cloud que criam fluxos de informações em tempo real, possibilitando aplicações e fluxos de trabalho personalizados
Device and Data Protection
Visão geralDevice and Data Protection
Proteja o que é importante, recupere quando for necessário
Soluções
Dados Confiáveis & IA
Visão geralDados Confiáveis & IA
Gestão Segura de Informações Encontra IA Confiável
OpenText™ Aviator™ Studio
Um lugar onde você pode criar, implantar e iterar agentes na linguagem dos seus dados
OpenText™ Discovery
Um conjunto de ferramentas para auxiliar na ingestão de dados e automatizar a marcação de metadados para impulsionar a IA
OpenText™ Data Compliance
Um conjunto de serviços e APIs que tornam a governança proativa e persistente
OpenText™ Aviator™ AI Services
Especialistas em serviços profissionais que ajudam você na sua jornada de IA
Informação Reimaginada
Visão geralInformação Reimaginada
Obtenha maior visibilidade e insights mais precisos a partir da gestão de informações orientada por IA. Pronto para ver como?
Conhecimento reimaginado
Transforme o trabalho diário com a gestão de conteúdo empresarial impulsionada por IA
Gestão de Serviços Reimaginada
Reduza o custo e a complexidade da gestão de serviços de TI, AIOps e observabilidade
Conexões reimaginadas
Integração B2B impulsionada por IA para o sucesso na cadeia de suprimentos
Conversas reimaginadas
Impulsione valor, crescimento e lealdade com experiências conectadas ao cliente
Engenharia reimaginada
Desenvolvimento ágil e entrega de software? Apenas parece impossível
Segurança reimaginada
Cibersegurança para a Empresa
Decisões reimaginadas
Desbloqueie insights com análise de dados de IA
Inteligência Artificial
Visão geralAviator AI
Veja informações de novas maneiras
OpenText™ Aviator™
IA que entende o seu negócio, os seus dados e os seus objetivos
OpenText™ Content Aviator™
Potencialize o trabalho com gerenciamento de conteúdo por IA e um assistente inteligente de conteúdo com IA
OpenText™ DevOps Aviator™
Permitir entrega mais rápida de aplicativos, desenvolvimento e testes automatizados de software
OpenText™ Experience Aviator™
Melhore a comunicação e as experiências dos clientes para o sucesso do cliente
OpenText™ Service Management Aviator™
Capacite usuários, agentes de serviço e equipe de TI a encontrar as respostas de que precisam
OpenText™ Trading Grid™ Aviator™
Desbloqueie conhecimentos, insights e ações guiadas por IA em toda a sua cadeia de suprimentos
OpenText™ Aviator™ Studio
Um lugar onde você pode criar, implantar e iterar agentes na linguagem dos seus dados
OpenText™ Aviator™ AI Services
Especialistas em serviços profissionais que ajudam você na sua jornada de IA
Indústria
Visão geralSoluções para a indústria
Melhore a eficiência, segurança e satisfação do cliente com OpenText
Energia e recursos
Transforme as operações de energia e recursos com a nuvem, cibersegurança e IA
Serviços financeiros
Melhore a experiência do cliente, a conformidade e a eficiência com IA
Governo
Reimagine sua missão com gerenciamento de informações seguras para o governo
Saúde e ciências da vida
Melhore a prestação de cuidados e o engajamento do paciente com soluções impulsionadas por IA
Legal
Modernize as equipes jurídicas com soluções tecnológicas jurídicas automatizadas e impulsionadas por IA
Manufatura
Modernizar as operações de manufatura e logística para reduzir custos e garantir conformidade
Varejo e bens de consumo
Aumente o engajamento do consumidor com soluções de varejo omnicanal e IA
Aplicativo Empresarial
Visão geralSoluções para Aplicações Empresariais
Execute processos mais rapidamente e com menos risco
Maximize o crescimento sustentado, o valor e a inovação com soluções empresariais inteligentes da OpenText e da SAP
Conecte o conteúdo aos processos empresariais para aumentar a produtividade e fortalecer a governança
Otimize a eficácia do Salesforce ao reunir dados transacionais e conteúdo não estruturado
Serviços
Serviços
Visão geralServiços
Acelere a transformação digital com a orientação de especialistas certificados
Serviços Profissionais
Modernize sua gestão de informações com especialistas certificados
Serviços de Sucesso do Cliente
Alcance metas de negócios com orientação especializada, serviços gerenciados e mais
Serviços de Suporte
Transforme o suporte em sua vantagem estratégica
Serviços Gerenciados
Libere suas equipes internas com a gestão especializada de serviços de TI
Serviços de Aprendizagem
Descubra opções de treinamento para ajudar usuários de todos os níveis de habilidade a adotar e usar produtos OpenText de forma eficaz
Serviços Profissionais
Visão geralServiços Profissionais
Modernize sua gestão de informações com especialistas certificados
Serviços de Sucesso do Cliente
Visão geralServiços de Sucesso do Cliente
Alcance metas de negócios com orientação especializada, serviços gerenciados e mais
Serviços de Suporte
Visão geralServiços de Suporte
Transforme o suporte em sua vantagem estratégica
Serviços Gerenciados
Visão geralServiços Gerenciados
Libere suas equipes internas com a gestão especializada de serviços de TI
Serviços de Aprendizagem
Visão geralServiços de Aprendizagem
Descubra opções de treinamento para ajudar usuários de todos os níveis de habilidade a adotar e usar produtos OpenText de forma eficaz
Parceiros
Encontre um Parceiro
Visão geralEncontre um parceiro
Encontre um parceiro OpenText altamente qualificado com a solução certa para viabilizar a transformação digital

Parceiros de Nuvem
Visão geralParceiros de Nuvem
A OpenText faz parceria com provedores líderes de infraestrutura em nuvem para oferecer a flexibilidade de executar soluções OpenText em qualquer lugar
Otimize o desempenho e reduza custos com aplicações implantadas em uma plataforma segura e escalada globalmente
Acelere a migração e a modernização com a implantação em uma nuvem pública altamente segura e em conformidade
Parceiros de Aplicativos Empresariais
Visão geralParceiros de Aplicativos Empresariais
A OpenText faz parceria com os principais provedores de aplicativos empresariais para liberar conteúdo não estruturado e obter melhores insights empresariais
Maximize o crescimento sustentado, o valor e a inovação com soluções empresariais inteligentes da OpenText e da SAP
Conecte o conteúdo aos processos empresariais para aumentar a produtividade e fortalecer a governança
Otimize a eficácia do Salesforce ao reunir dados transacionais e conteúdo não estruturado
Soluções de Parceiros
Visão geralSoluções de Parceiros
Descubra ofertas flexíveis e inovadoras projetadas para agregar valor às soluções OpenText
Recursos para Parceiros
Visão geralRecursos para Parceiros
Descubra os recursos disponíveis para apoiar e expandir as capacidades dos parceiros
Suporte
Visão geralSuporte ao Cliente
Obtenha suporte especializado para produtos e serviços a fim de acelerar a resolução de problemas e manter os fluxos de negócios funcionando eficientemente
Recursos
Visão geralRecursos
Explore apresentações detalhadas de serviços e consultoria, resumos, documentação e outros recursos
Escolha sua região:
Europa, Oriente Médio e África
Ásia-Pacífico
O que é a prevenção de incidentes?
Veja como o AIOps e a observabilidade ajudam as equipes de TI a prevenir incidentes, e não apenas a reagir a eles
Visão geral
A prevenção de incidentes consiste na prática de utilizar a observabilidade, o contexto do serviço e a IA para impedir que os incidentes cheguem aos usuários, em vez de resolvê-los mais rapidamente após a ocorrência.
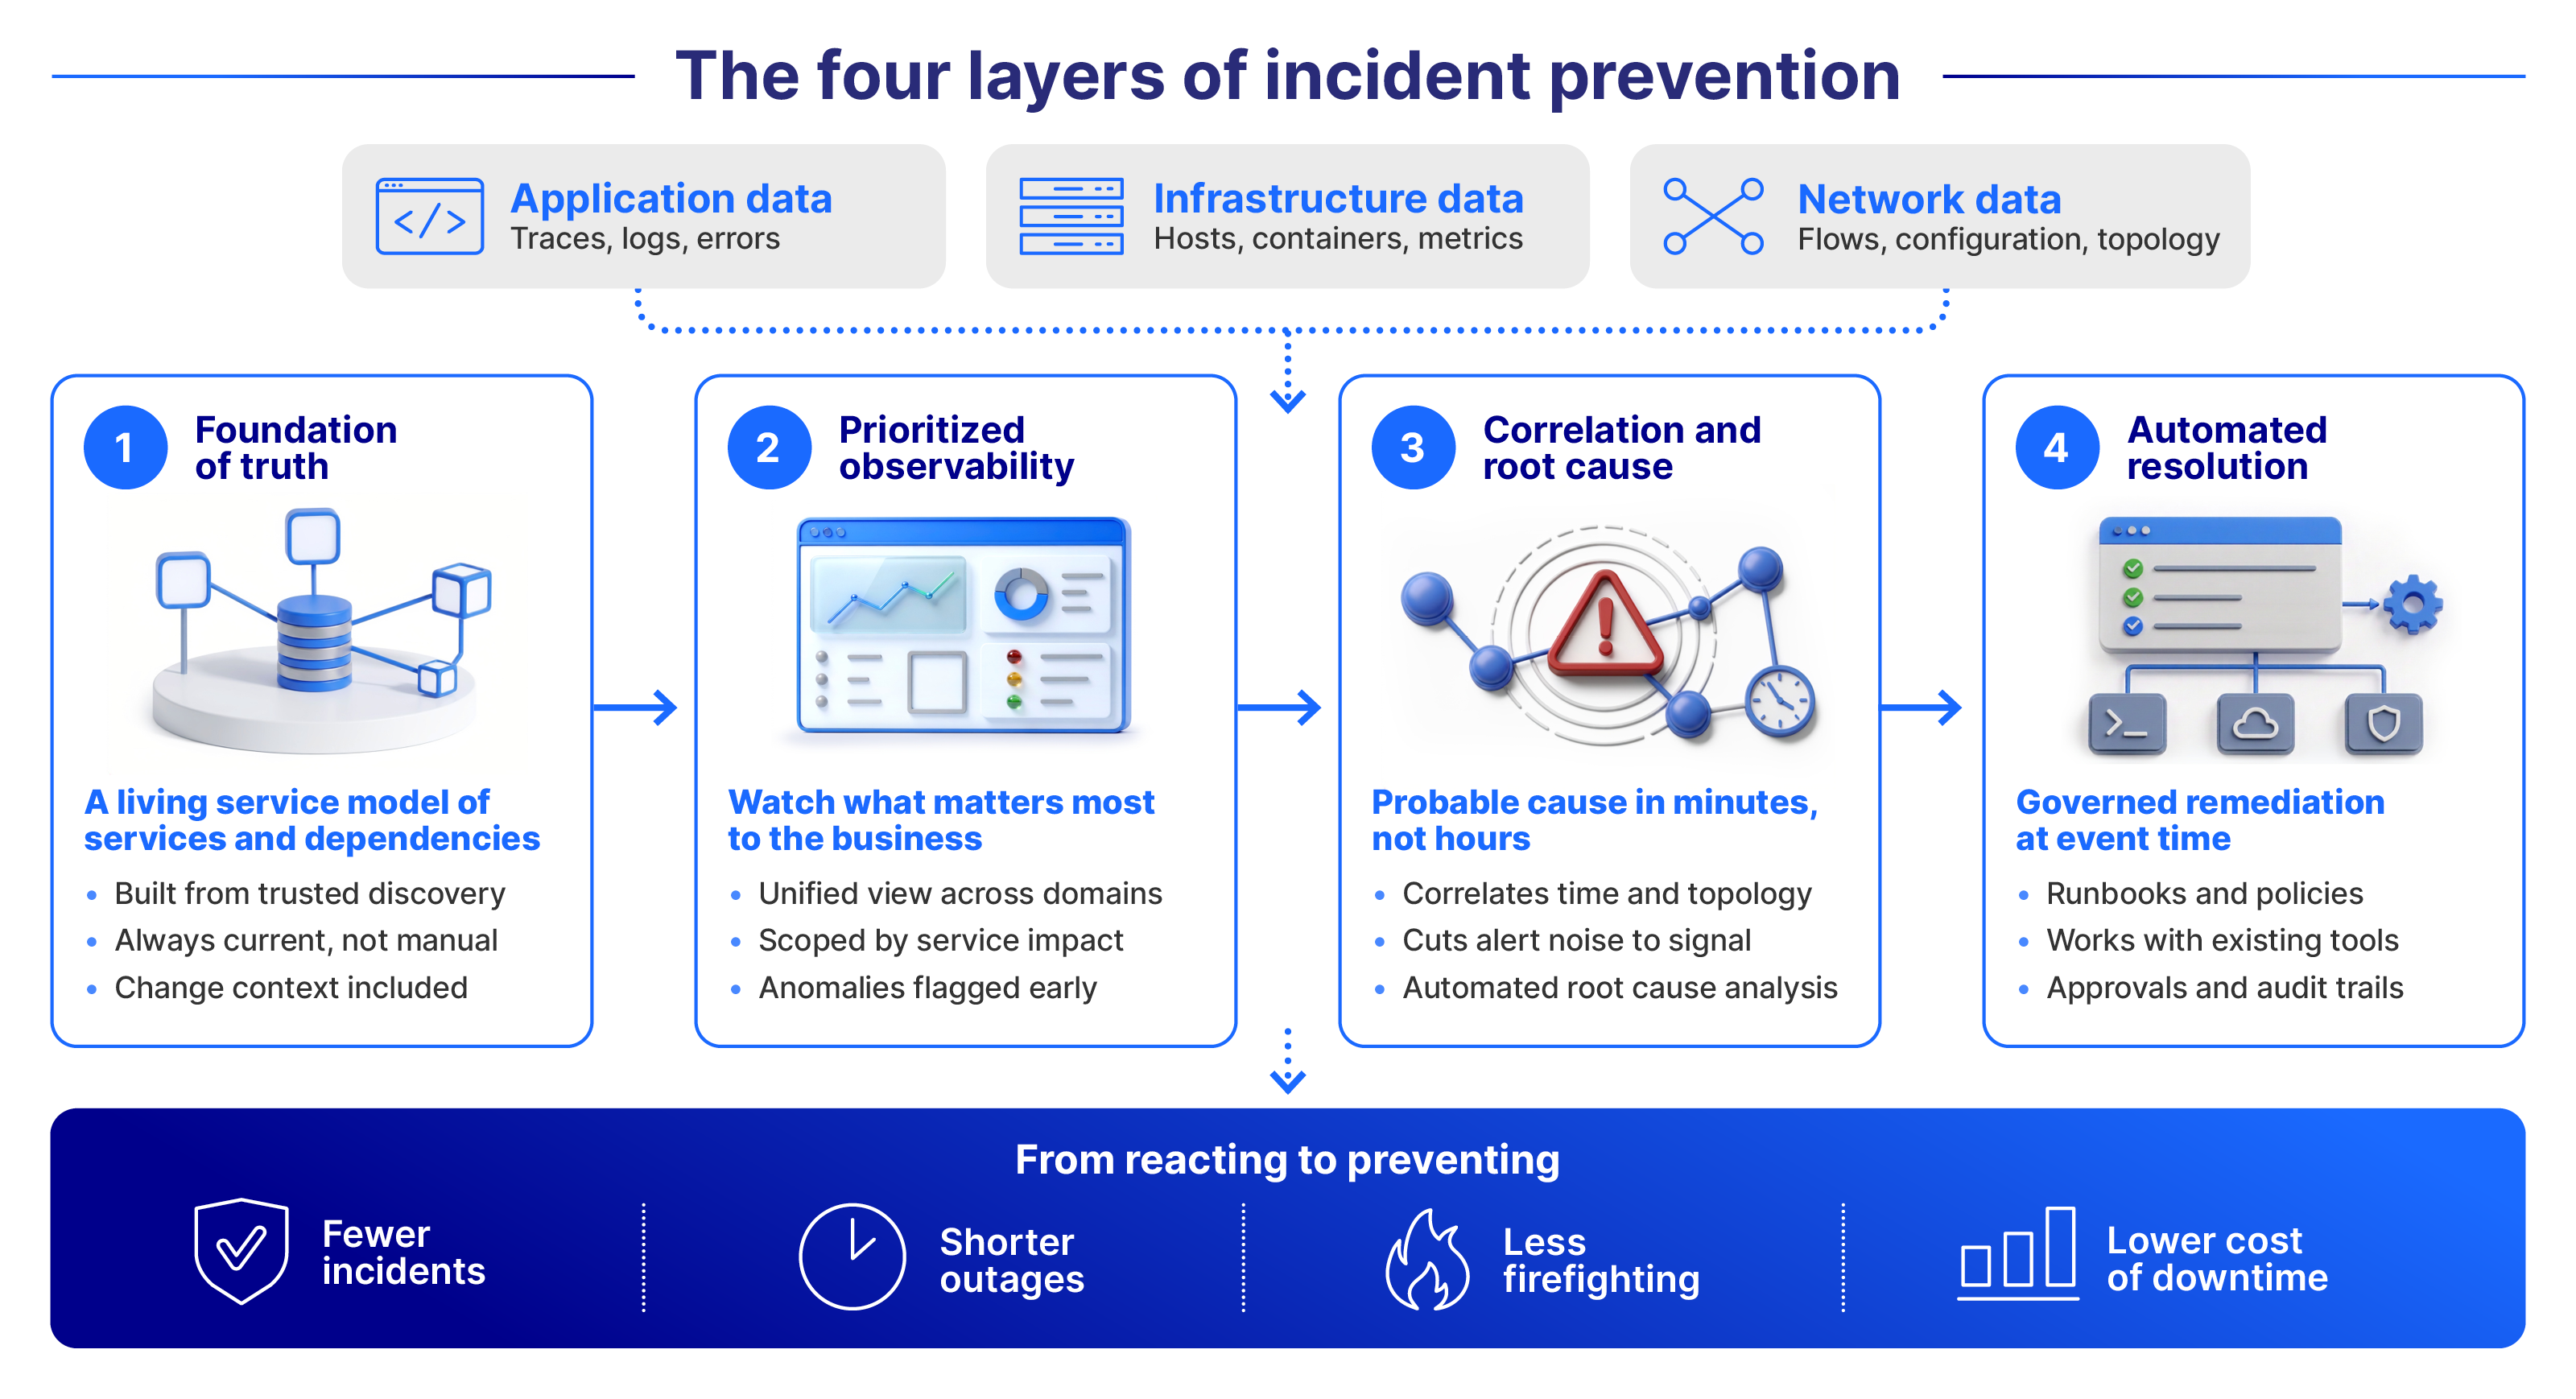
Baseia-se em quatro capacidades, cada uma delas construída a partir da anterior:
- Uma visão confiável do que existe no meio ambiente
- Observabilidade com foco no que realmente importa
- Análise rápida da causa raiz
- Correção automatizada supervisionada
Prevenção de incidentes
Quais são os benefícios da prevenção de incidentes?
- Reduza o tempo de inatividade e o MTTR: identifique problemas de conformação antecipadamente e diminua o tempo gasto na identificação da causa raiz.
- Liberte sua equipe: com menos salas de crise e menos correlação manual, os engenheiros passam a dedicar seu tempo a tarefas de maior valor agregado, em vez de ficarem correndo atrás de alertas.
- Reforce sua postura de segurança: o mesmo contexto de alterações e configurações que agiliza a análise da causa raiz também identifica mais rapidamente alterações não autorizadas ou de risco.
- Reforçar a conformidade: registros abrangentes e trilhas de auditoria facilitam a demonstração do controle sobre as alterações e os incidentes de TI.
- Reduzir o custo das interrupções: incidentes menos frequentes e de menor duração significam menor impacto na receita e menores custos com mão de obra não programada.
- Construa a confiança na automação de forma gradual: a automação controlada e com intervenção humana conquista a confiança necessária para ampliar a autonomia ao longo do tempo.
Quais são as quatro camadas de prevenção de incidentes?
A prevenção não é um recurso isolado. Não é possível resolver automaticamente um problema sem conhecer sua causa provável. Não é possível identificar uma causa provável sem os dados de observabilidade adequados. Não é possível observar o que é importante sem saber o que existe em seu ambiente e o que ele oferece. Cada camada alimenta a seguinte.
- Base da verdade: um mapa sempre atualizado e de fácil consulta dos serviços e de suas dependências entre aplicativos, infraestrutura e rede, criado a partir da detecção automática e mantido atualizado por IA, em vez de um registro mantido manualmente. É desse modelo de serviço dinâmico que tudo o mais depende.
- Observabilidade priorizada e integrada: telemetria focada no que é mais importante, com base em quais ativos dão suporte a quais serviços de negócios. É aqui que os problemas de conformação são sinalizados antes que um limite seja atingido.
- Correlação e causa raiz: correlação automatizada de eventos que analisa todo o contexto para identificar a causa provável em questão de minutos, com índices de confiança e lógica rastreável, em vez de uma série de alertas isolados.
- Resolução automatizada: automação baseada em playbooks e políticas, que executa medidas de correção comprovadas no momento em que surge um sinal, trabalhando com os scripts, playbooks e ferramentas que você já utiliza.
Saiba por que a prevenção de incidentes é importante
Em que medida a prevenção de incidentes difere da resposta tradicional a incidentes?
As operações tradicionais de TI são avaliadas com base no MTTR, ou seja, na rapidez com que se recupera após a ocorrência de um incidente. Essa é uma medida inadequada, uma vez que uma plataforma é capaz de identificar situações em desenvolvimento, determinar a causa provável em questão de minutos e agir de acordo com as diretrizes de governança. A prevenção de incidentes muda o foco da avaliação: em vez de se levar em conta a rapidez com que se resolve o problema, passa-se a considerar quantos incidentes e quantas horas de sala de crise se evitam desde o início.
| Resposta tradicional | Prevenção de incidentes |
|---|---|
| Detectar após a falha | Detectar antes do impacto |
| Foco no MTTR | Foco na prevenção de incidentes |
| Reativo | Proativo |
| Investigação manual | Correlação assistida por IA |
Qual é o papel da IA na prevenção de incidentes?
A IA está presente em todas as etapas da prevenção de incidentes, embora seu papel varie de acordo com a função.
- Detecção: Os modelos de aprendizado de máquina identificam anomalias e correlacionam eventos relacionados em um único panorama, detectando problemas em formação antes que um limite seja ultrapassado.
- Diagnóstico: a IA analisa a topologia, as alterações recentes e os dados de telemetria para identificar a causa raiz provável, muitas vezes com um índice de confiança que o operador pode questionar e refinar.
- Resolução: A IA pode associar um diagnóstico à automação, identificando ou criando etapas de correção. A maioria das organizações mantém um profissional envolvido nessa etapa, ampliando a autonomia à medida que a confiança no sistema aumenta.
O grau de maturidade varia significativamente entre as plataformas e, mesmo dentro de uma determinada plataforma, o diagnóstico e a resolução baseados em IA tendem a estar mais avançados do que a detecção totalmente autônoma de problemas que ainda não tenham acionado um alerta.
Por que a rede é importante na prevenção de incidentes?
Uma grande parte dos incidentes tem origem na rede ou passa por ela, e a análise da causa raiz precisa acompanhar uma transação de ponta a ponta para ser confiável. Isso torna a rede um elemento fundamental, e não um aspecto secundário em relação aos aplicativos e à infraestrutura.
Isso também é importante especificamente para a camada de resolução automatizada. A correção automatizada segura depende da verificação, da reversão, dos limites de política, da correção de desvios e da geração de planos de mudança — recursos que fazem parte da automação de rede. O Ciclo de Hype da Gartner para SRE define as operações de rede agentas como um aprimoramento da automação de rede, e não como uma substituição, e seus critérios de execução correspondem diretamente a esses mesmos recursos. Em termos simples, a IA é o raciocínio; a automação de rede é o que permite que ela atue com segurança.
Quais são os desafios que as organizações enfrentam ao implementar medidas de prevenção de incidentes?
- Dados fragmentados: a telemetria de aplicativos, infraestrutura e rede costuma estar dispersa em ferramentas distintas, sem um contexto comum.
- Registros de serviço desatualizados: uma CMDB mantida manualmente fica desatualizada no momento em que o ambiente sofre alterações, o que compromete tudo o que foi construído com base nela.
- Fadiga de alertas: sem uma priorização vinculada ao impacto nos negócios, as equipes ficam sobrecarregadas com o excesso de informações antes mesmo de poderem agir sobre o que realmente importa.
- Conquistando a confiança na automação: as equipes, com razão, desejam ver a automação funcionando de maneira correta e previsível antes de ampliar o escopo das ações que ela pode realizar de forma autônoma.
As organizações que atuam dessa maneira tendem a começar pela base (um modelo de serviço atual e confiável) antes de incorporar a automação, mantêm o ser humano envolvido à medida que o escopo da automação se expande e escolhem ferramentas que se integram ao que já utilizam, em vez de exigir uma substituição total.
Como a OpenText pode ajudar na prevenção de incidentes?
A OpenText oferece atualmente todas as quatro camadas de prevenção de incidentes, com base nos resultados alcançados por seus clientes nos setores de telecomunicações, serviços financeiros e outros.
- O OpenText™ AI Operations Management unifica a observabilidade, a correlação e a automação regulamentada entre aplicativos, infraestrutura e rede.
- A OpenText™ Network Observability integra a rede a esse mesmo panorama correlacionado, uma vez que a conectividade e as falhas decorrentes de alterações representam uma grande parcela das interrupções reais.
- O OpenText™ Automation Center executa correções regulamentadas, conectando o diagnóstico à ação.
Resources
Produtos relacionados
OpenText™ AI Operations Management
Unifique a observabilidade e automatize a resolução em todo o seu ambiente de TI
OpenText™ Network Observability
Inclua a rede no mesmo panorama correlacionado das aplicações e da infraestrutura
OpenText™ Automation Center
Gerenciar e executar correções automatizadas em grande escala


